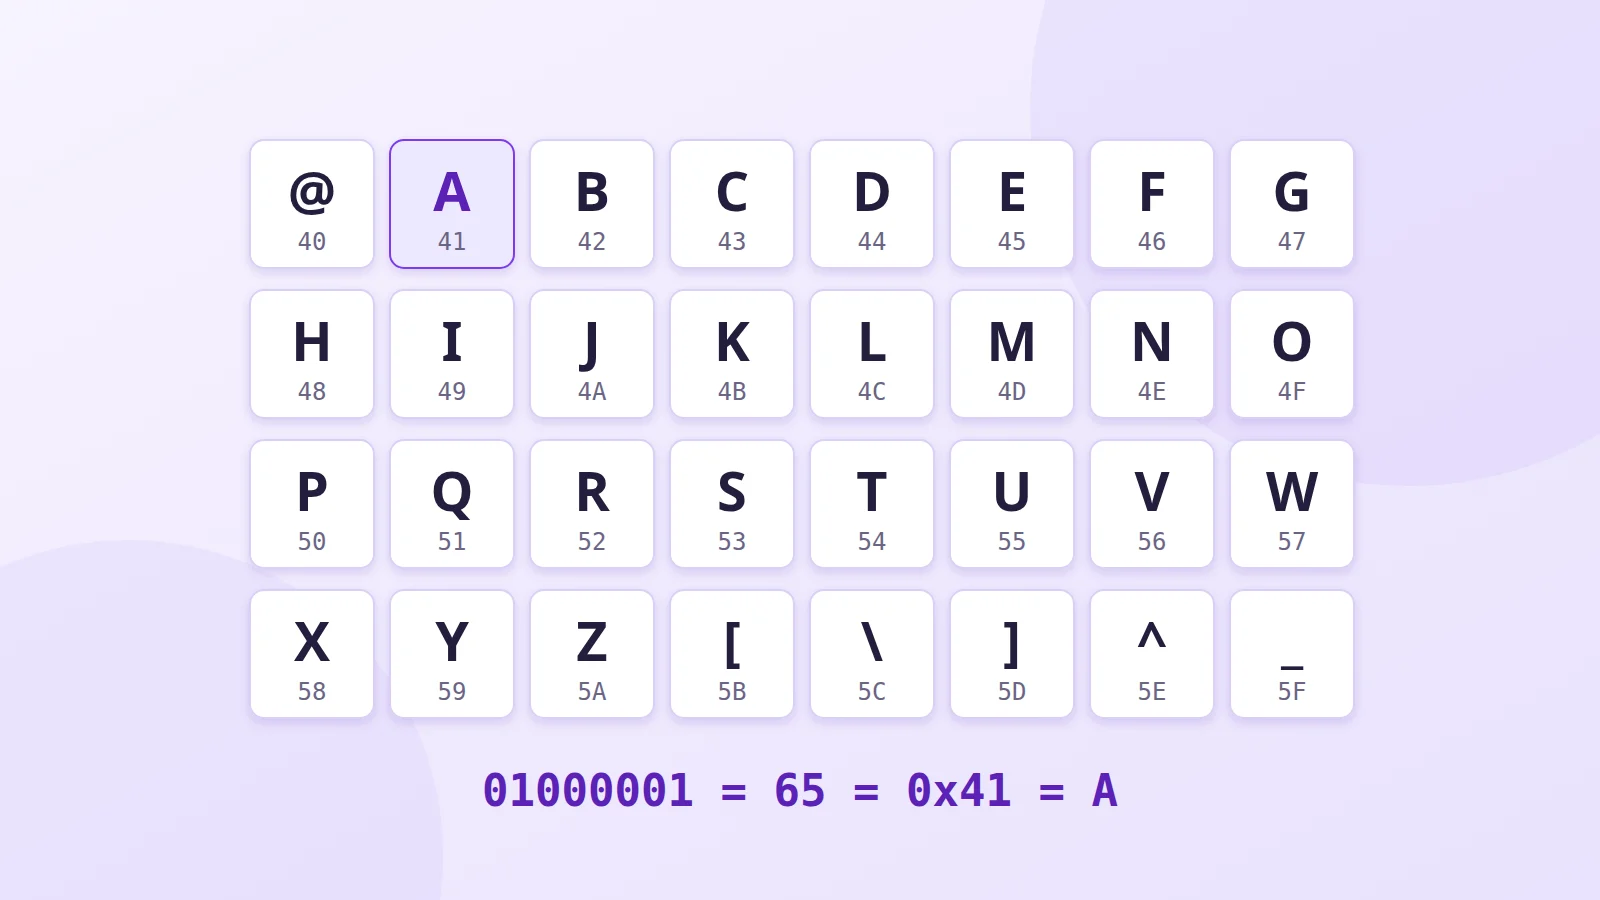
Ein Computer versteht nur Zahlen. Um den Buchstaben A anzuzeigen, braucht er eine Tabelle, die sagt: „Die Zahl 65 ist A.“ Diese Tabelle ist eine Zeichenkodierung. Die älteste, die noch überall im Einsatz ist, heißt ASCII; ihr Nachfolger Unicode sorgt heute dafür, dass Sie Arabisch, Russisch und Emojis auf derselben Seite lesen können.
Vor ASCII: der Telegraf
Schon das Morsealphabet des 19. Jahrhunderts stellte Buchstaben als Signale dar, war aber für das Ohr eines Funkers gedacht, nicht für eine Maschine: Jeder Buchstabe war unterschiedlich lang.
Die Fernschreiber des frühen 20. Jahrhunderts übernahmen einen 5-Bit-Code, abgeleitet von dem des Franzosen Émile Baudot und als ITA2 genormt. Fünf Bit ergeben nur 32 Kombinationen, zu wenig für Buchstaben und Ziffern. Ein Sonderzeichen schaltete deshalb zwischen „Buchstaben“ und „Ziffern“ um, und ein einziger Übertragungsfehler konnte eine ganze Nachricht in Zahlen verwandeln.
Die Geburt von ASCII (1963–1967)
Anfang der 1960er-Jahre hatte jeder Computerhersteller seine eigene Kodierung, und die Maschinen konnten keinen Text austauschen. Die American Standards Association rief daher ein Komitee zusammen, unter anderem mit IBM und AT&T, um einen gemeinsamen Code festzulegen: den American Standard Code for Information Interchange, kurz ASCII.
Das Komitee entschied sich für 7 Bit, also 128 Zeichen. Die erste Fassung von 1963 enthielt nicht einmal Kleinbuchstaben; die kamen erst mit der Revision von 1967, die sich dann überall durchsetzte.
Was in der ASCII-Tabelle steht
- 0 bis 31 und 127: Steuerzeichen. Sie werden nicht angezeigt; mit ihnen wurden Fernschreiber gesteuert. Einige sind noch in Gebrauch: Tabulator (9), Zeilenvorschub (10), Wagenrücklauf (13), Escape (27).
- 32: das Leerzeichen.
- 48 bis 57: die Ziffern 0 bis 9.
- 65 bis 90: die Großbuchstaben A bis Z, und 97 bis 122: die Kleinbuchstaben.
- Der Rest: Satzzeichen und Symbole wie @, #, $ oder {.
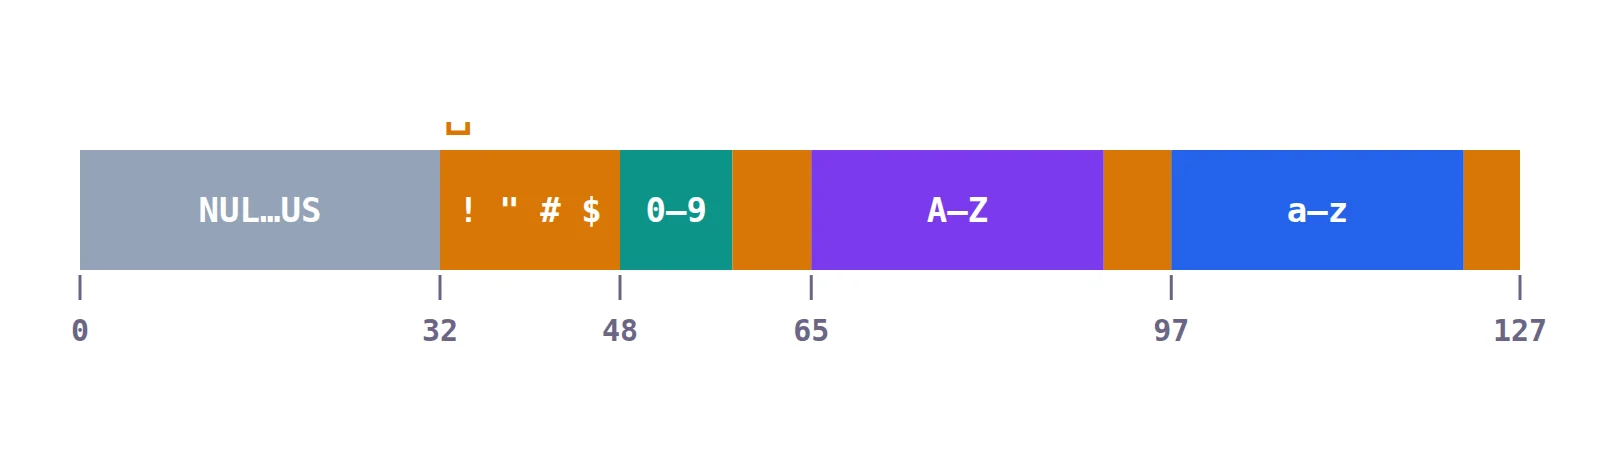
Die Reihenfolge ist kein Zufall. Die Buchstaben stehen alphabetisch, was das Sortieren erleichtert, und Groß- und Kleinbuchstabe liegen immer 32 auseinander, was die Umwandlung für ein Programm trivial macht.
Das Problem mit den Umlauten
128 Zeichen reichen für Englisch, aber nicht für den Rest der Welt. ASCII kennt weder ä, ö, ü noch ß, und keinen einzigen arabischen, russischen oder chinesischen Buchstaben.
Da ein Byte 8 Bit hat, nutzte man das freie Bit für 128 weitere Zeichen. Doch jede Region belegte sie auf ihre Weise: Das sind die „Codepages“. ISO-8859-1 und Windows-1252 für Westeuropa, ISO-8859-5 für Kyrillisch, Windows-1256 für Arabisch, Shift-JIS für Japanisch …
Dasselbe Byte konnte also in Deutschland ä und in Russland einen kyrillischen Buchstaben bedeuten. Mit der falschen Codepage gelesen, wurde ein Text unlesbar: Zeichensalat, auf Englisch „Mojibake“. Viele erinnern sich an „ä“ statt „ä“ in E-Mails. Und Deutsch, Russisch und Arabisch im selben Dokument zu mischen, war unmöglich.
Unicode: eine Nummer für jedes Zeichen
Unicode, erstmals 1991 veröffentlicht, löst das Problem an der Wurzel: Jedes Zeichen jeder Schrift bekommt eine eindeutige Nummer, seinen Codepunkt, egal in welchem Land oder Programm.
- U+0041: A
- U+00E4: ä
- U+0627: ا (arabisches Alif)
- U+042F: Я (kyrillisches Ja)
- U+1F600: 😀
Unicode umfasst heute mehr als 150.000 Zeichen: alle modernen Schriften, viele historische, mathematische Symbole und Emojis. Die ersten 128 Codepunkte sind genau die von ASCII.
UTF-8: wie sie gespeichert werden
Unicode vergibt Nummern; gespeichert werden müssen sie als Bytes. Die verbreitetste Kodierung ist UTF-8, 1992 von Ken Thompson und Rob Pike entworfen:
- ASCII-Zeichen belegen 1 Byte, genau wie vorher, sodass eine ASCII-Datei zugleich eine gültige UTF-8-Datei ist;
- Umlaute, Akzentbuchstaben, Arabisch, Griechisch, Kyrillisch und Hebräisch belegen 2;
- die meisten chinesischen, japanischen und koreanischen Zeichen belegen 3;
- Emojis belegen 4.
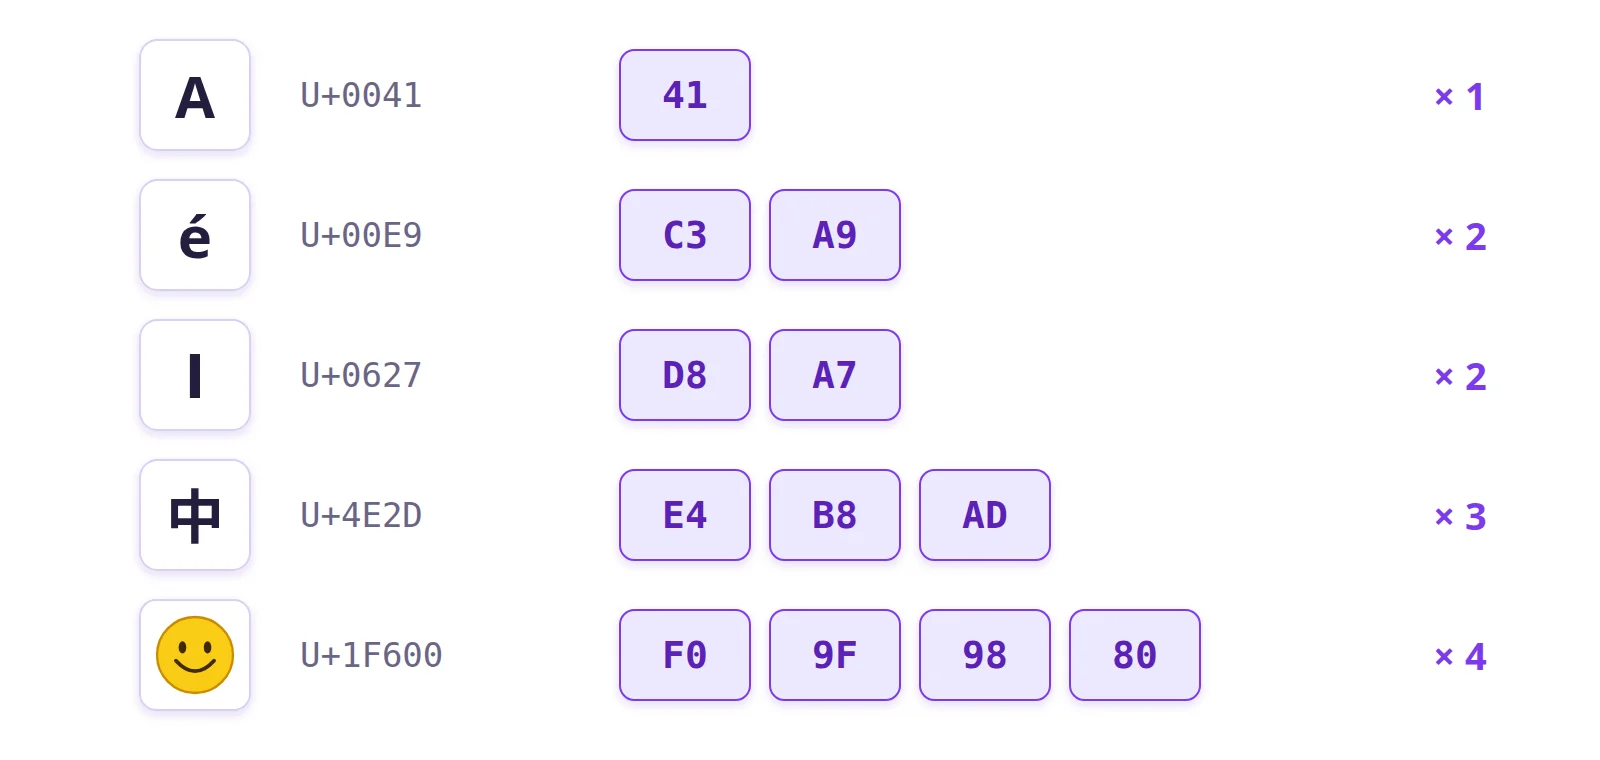
Diese Kompatibilität mit ASCII erklärt den Erfolg: Heute verwenden über 98 % aller Websites UTF-8. Wenn ein Text noch „ä“ zeigt, hat fast immer ein Programm UTF-8 so gelesen, als wäre es Windows-1252.
Wo man ASCII noch begegnet
- Im Quellcode: Schlüsselwörter, Variablennamen und Operatoren sind fast immer ASCII.
- In Web- und Mailprotokollen (HTTP, SMTP), die ihre Befehle als ASCII-Text austauschen.
- Im Terminal, wo Farben noch immer über Sequenzen gesteuert werden, die mit dem Escape-Zeichen beginnen.
- In Emoticons wie :-) und ASCII-Art, entstanden, als man nur diese 95 druckbaren Zeichen hatte.
Weiterlesen
- Akzente und Sonderbuchstaben: so tippen Sie sie
- Die Geschichte der Emojis
- Chinesisch tippen: Pinyin und Wubi
- Vollständige ASCII-Tabelle
- Das Unicode-Konsortium
- Die Geschichte von UTF-8, erzählt von Rob Pike (Englisch)