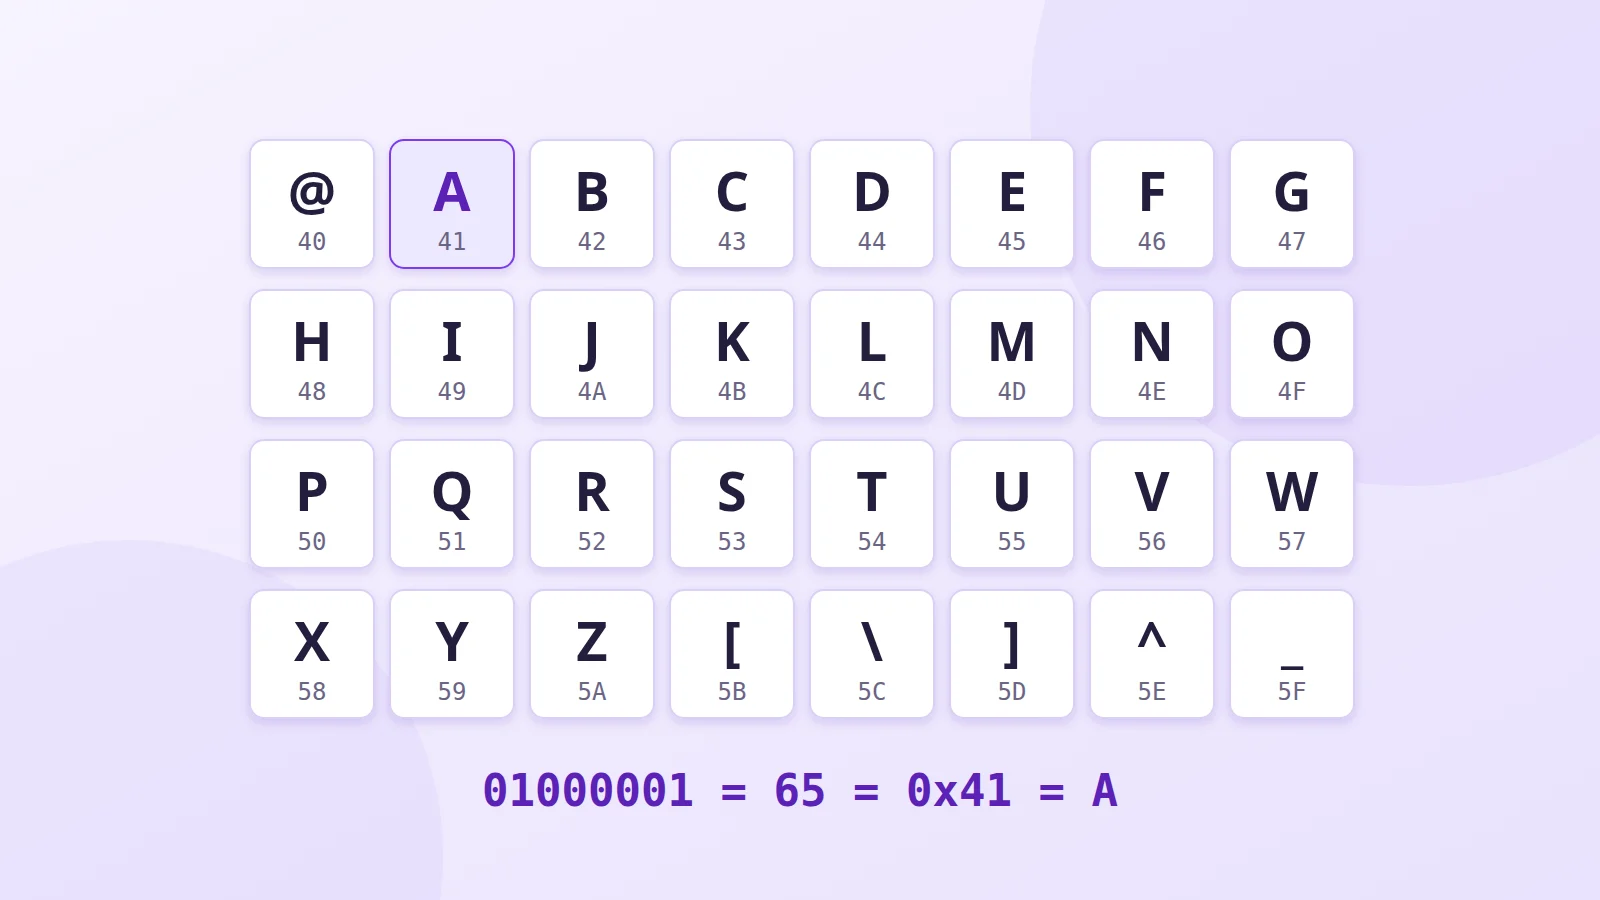
Un ordinateur ne connaît que des nombres. Pour afficher la lettre A, il lui faut une table qui dise : « le nombre 65 correspond à A ». Cette table, c'est un codage de caractères. Le plus ancien encore utilisé partout s'appelle ASCII ; son successeur, Unicode, est ce qui vous permet aujourd'hui de lire de l'arabe, du russe et des émojis sur la même page.
Avant ASCII : le télégraphe
Le code Morse, au XIXe siècle, représentait déjà les lettres par des signaux, mais il était fait pour l'oreille d'un opérateur, pas pour une machine : chaque lettre avait une longueur différente.
Les téléscripteurs du début du XXe siècle ont adopté un code à 5 bits, dérivé de celui du Français Émile Baudot et normalisé sous le nom d'ITA2. Cinq bits ne donnent que 32 combinaisons : pas assez pour les lettres et les chiffres. Il fallait donc envoyer un caractère spécial pour passer du mode « lettres » au mode « chiffres », et une erreur de transmission pouvait transformer tout un message en chiffres.
La naissance d'ASCII (1963-1967)
Au début des années 1960, chaque fabricant d'ordinateurs avait son propre codage, et les machines ne pouvaient pas échanger de texte. L'American Standards Association réunit alors un comité, avec IBM, AT&T et d'autres, pour définir un code commun : l'American Standard Code for Information Interchange, ou ASCII.
Le comité choisit 7 bits, soit 128 caractères. La première version, en 1963, ne contenait même pas les minuscules ; elles arrivent avec la révision de 1967, qui s'impose ensuite partout.
Ce que contient la table ASCII
- 0 à 31 et 127 : les caractères de contrôle. Ils ne s'affichent pas ; ils servaient à piloter les téléscripteurs. Plusieurs sont toujours utilisés : la tabulation (9), le saut de ligne (10), le retour chariot (13), Échap (27).
- 32 : l'espace.
- 48 à 57 : les chiffres 0 à 9.
- 65 à 90 : les majuscules A à Z, et 97 à 122 : les minuscules a à z.
- Le reste : la ponctuation et les symboles comme @, #, $ ou {.
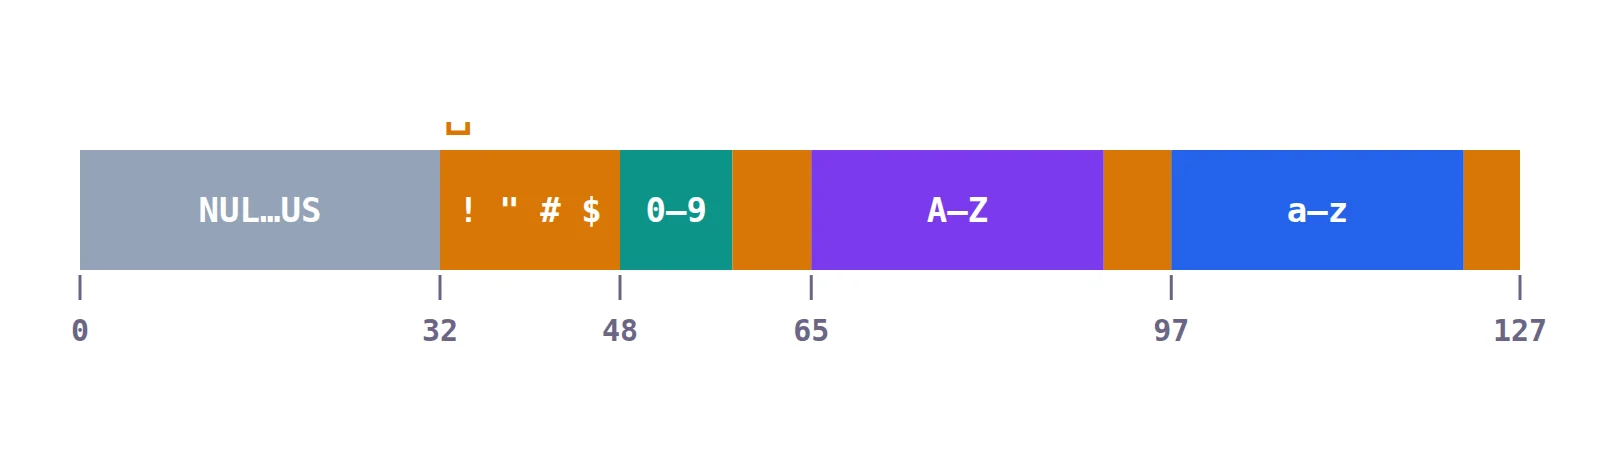
L'ordre n'est pas dû au hasard. Les lettres se suivent dans l'ordre alphabétique, ce qui simplifie le tri, et une majuscule et sa minuscule sont toujours séparées de 32, ce qui rend le passage de l'une à l'autre très simple pour un programme.
Le problème des accents
128 caractères suffisent pour l'anglais, pas pour le reste du monde. ASCII n'a ni é, ni ñ, ni ü, ni aucune lettre arabe, russe ou chinoise.
Comme un octet compte 8 bits, on a utilisé le bit restant pour ajouter 128 caractères. Mais chaque région les a remplis à sa manière : ce sont les « pages de code ». ISO-8859-1 et Windows-1252 pour l'Europe de l'Ouest, ISO-8859-5 pour le cyrillique, Windows-1256 pour l'arabe, Shift-JIS pour le japonais…
Le même octet pouvait donc désigner é en France et une lettre cyrillique en Russie. Si un texte était lu avec la mauvaise page de code, il devenait illisible : c'est le « mojibake ». Beaucoup se souviennent des « é » à la place des « é » dans les e-mails. Et il était impossible de mélanger dans un même document du français, du russe et de l'arabe.
Unicode : un numéro pour chaque caractère
Unicode, dont la première version paraît en 1991, règle le problème à la racine : chaque caractère de chaque écriture reçoit un numéro unique, son point de code, quel que soit le pays ou le logiciel.
- U+0041 : A
- U+00E9 : é
- U+0627 : ا (alif arabe)
- U+042F : Я (ya cyrillique)
- U+1F600 : 😀
Unicode compte aujourd'hui plus de 150 000 caractères : toutes les écritures modernes, beaucoup d'écritures anciennes, des symboles mathématiques et les émojis. Les 128 premiers points de code sont exactement ceux d'ASCII.
UTF-8 : la façon de les stocker
Unicode attribue des numéros ; il reste à les enregistrer en octets. Le codage le plus répandu est UTF-8, conçu en 1992 par Ken Thompson et Rob Pike :
- les caractères ASCII occupent 1 octet, exactement comme avant : un fichier ASCII est aussi un fichier UTF-8 valide ;
- les lettres accentuées, l'arabe, le grec, le cyrillique ou l'hébreu en occupent 2 ;
- la plupart des caractères chinois, japonais et coréens en occupent 3 ;
- les émojis en occupent 4.
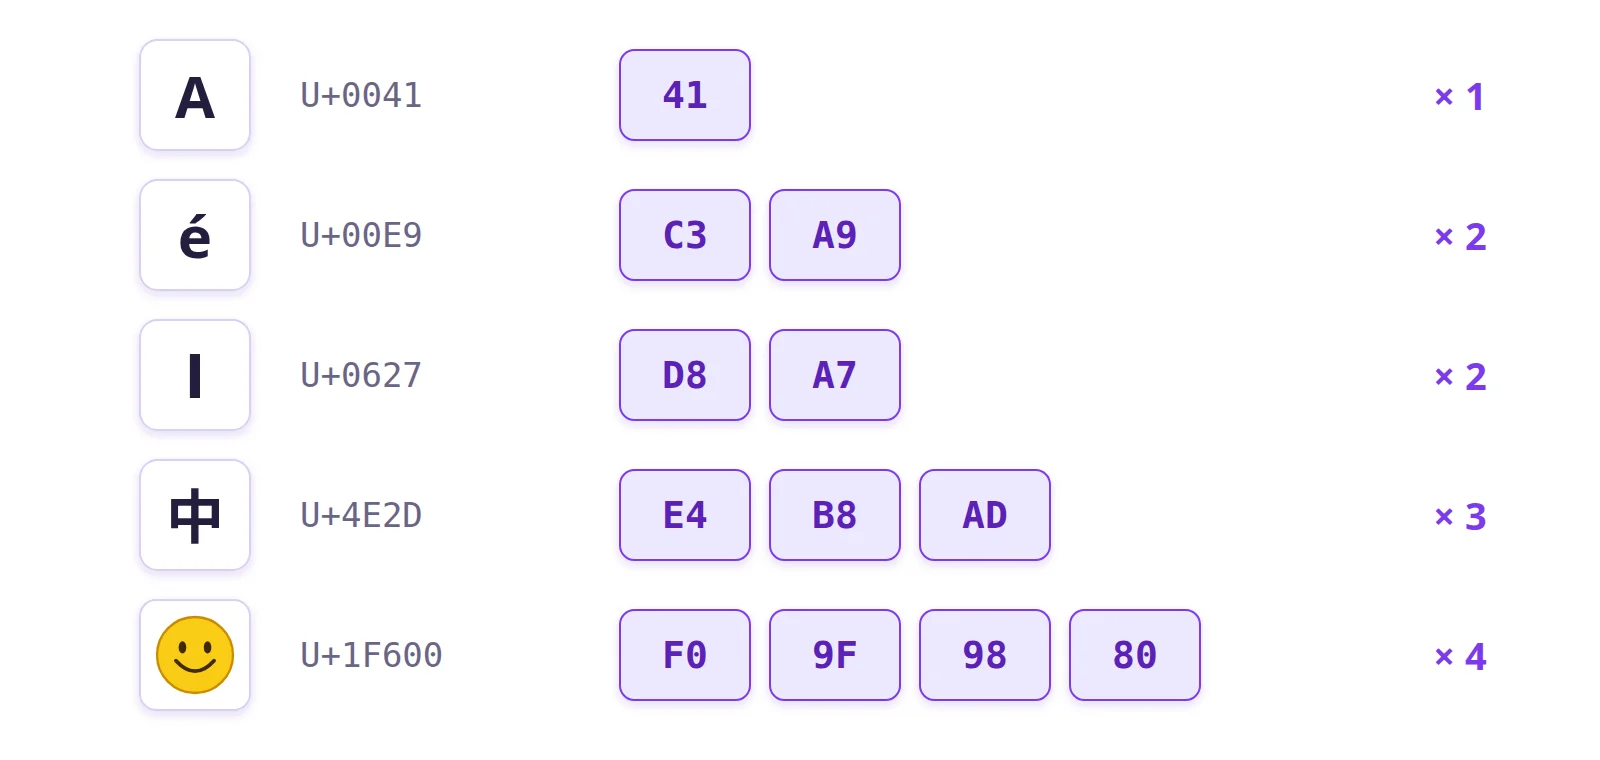
Cette compatibilité avec ASCII explique son succès : aujourd'hui, plus de 98 % des sites web sont en UTF-8. Si un texte s'affiche encore avec des « é », c'est presque toujours qu'un logiciel l'a lu en Windows-1252 alors qu'il était en UTF-8.
Où l'on croise encore ASCII
- Le code informatique : mots-clés, noms de variables et opérateurs sont presque toujours en ASCII.
- Les protocoles du web et du courrier (HTTP, SMTP) échangent leurs commandes en texte ASCII.
- Le terminal, où les couleurs sont encore commandées par des séquences qui commencent par le caractère Échap.
- Les émoticônes comme :-) et l'art ASCII, nés quand on ne disposait que de ces 95 caractères affichables.
Pour aller plus loin
- Accents et lettres spéciales : comment les taper
- L'histoire des émojis
- Taper en chinois : pinyin et wubi
- Table ASCII complète
- Le consortium Unicode
- L'histoire d'UTF-8 racontée par Rob Pike (en anglais)