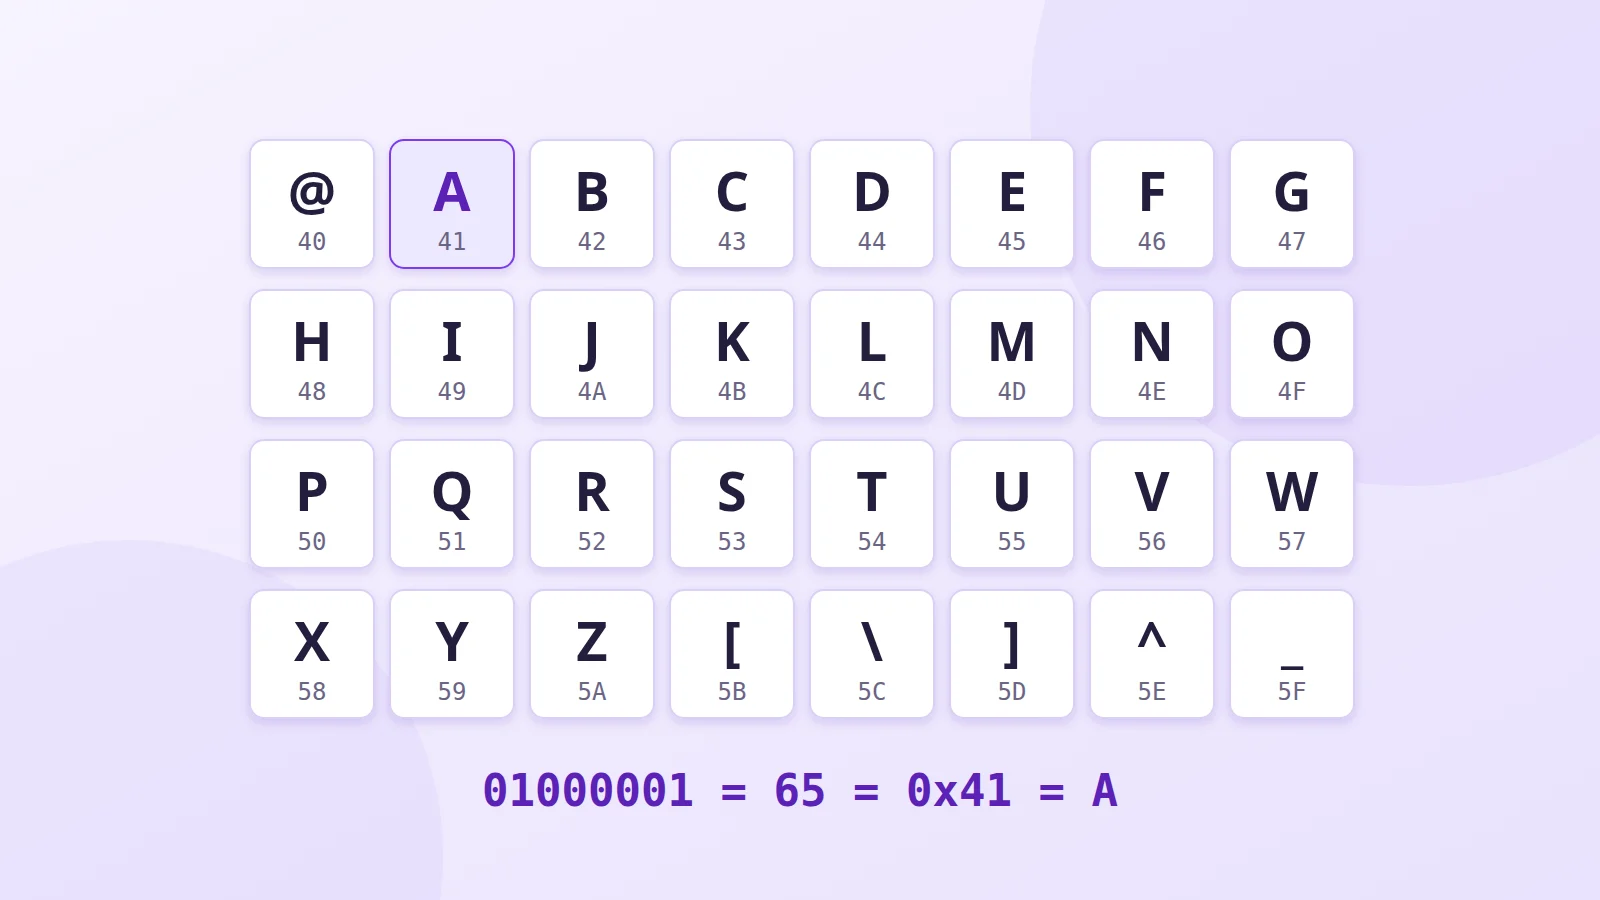
Un computer capisce solo numeri. Per mostrare la lettera A gli serve una tabella che dica: "il numero 65 è la A". Questa tabella è una codifica dei caratteri. La più antica ancora usata ovunque si chiama ASCII; la sua erede, Unicode, è ciò che oggi ti permette di leggere arabo, russo ed emoji nella stessa pagina.
Prima di ASCII: il telegrafo
Il codice Morse dell'Ottocento rappresentava già le lettere con dei segnali, ma era pensato per l'orecchio di un operatore, non per una macchina: ogni lettera aveva una durata diversa.
Le telescriventi dei primi del Novecento adottarono un codice a 5 bit, derivato da quello del francese Émile Baudot e normalizzato come ITA2. Cinque bit danno solo 32 combinazioni, troppo poche per lettere e cifre. Un carattere speciale faceva quindi passare dalla modalità "lettere" alla modalità "cifre", e un solo errore di trasmissione poteva trasformare un intero messaggio in numeri.
La nascita di ASCII (1963-1967)
All'inizio degli anni Sessanta ogni produttore di computer aveva la propria codifica, e le macchine non potevano scambiarsi testo. L'American Standards Association riunì allora un comitato, con IBM e AT&T tra gli altri, per definire un codice comune: l'American Standard Code for Information Interchange, o ASCII.
Il comitato scelse 7 bit, cioè 128 caratteri. La prima versione, del 1963, non aveva nemmeno le minuscole; arrivarono con la revisione del 1967, che poi si diffuse ovunque.
Cosa contiene la tabella ASCII
- Da 0 a 31 e 127: i caratteri di controllo. Non vengono visualizzati; servivano a comandare le telescriventi. Diversi sono ancora in uso: tabulazione (9), a capo (10), ritorno carrello (13), Esc (27).
- 32: lo spazio.
- Da 48 a 57: le cifre da 0 a 9.
- Da 65 a 90: le maiuscole dalla A alla Z, e da 97 a 122: le minuscole.
- Il resto: punteggiatura e simboli come @, #, $ o {.
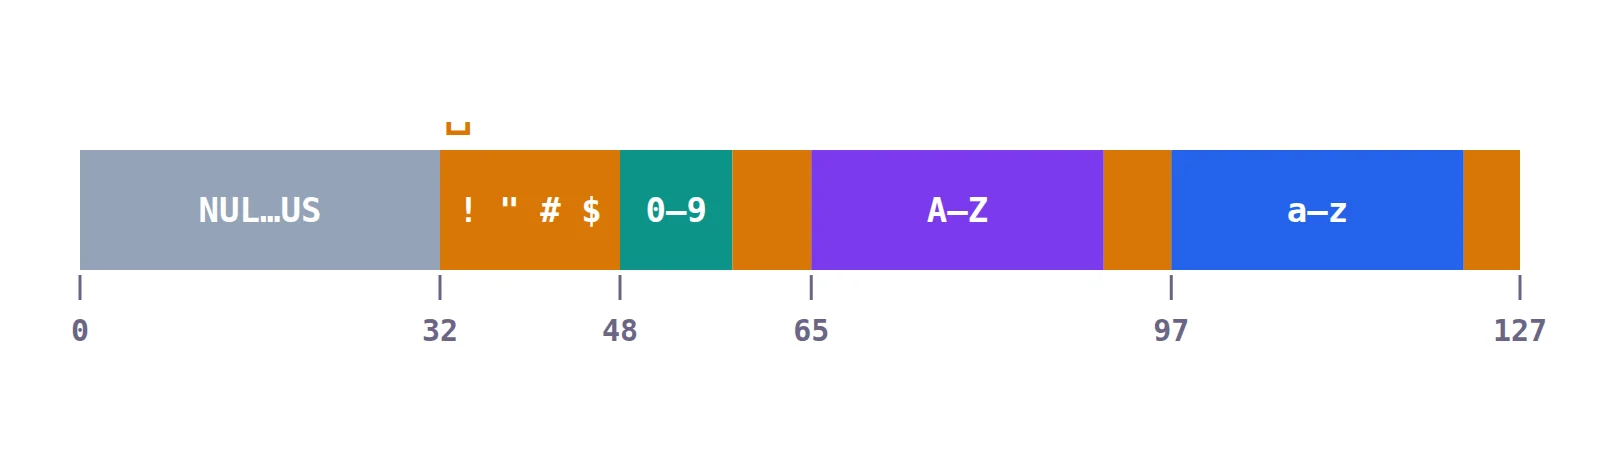
L'ordine non è casuale. Le lettere seguono l'ordine alfabetico, il che facilita l'ordinamento, e una maiuscola e la sua minuscola distano sempre 32, il che rende banale il passaggio dall'una all'altra in un programma.
Il problema degli accenti
128 caratteri bastano per l'inglese, non per il resto del mondo. ASCII non ha è, à, ñ o ü, né alcuna lettera araba, russa o cinese.
Poiché un byte ha 8 bit, si usò il bit avanzato per aggiungere altri 128 caratteri. Ma ogni regione li riempì a modo suo: sono le "code page". ISO-8859-1 e Windows-1252 per l'Europa occidentale, ISO-8859-5 per il cirillico, Windows-1256 per l'arabo, Shift-JIS per il giapponese…
Lo stesso byte poteva quindi significare è in Italia e una lettera cirillica in Russia. Letto con la code page sbagliata, un testo diventava illeggibile: è il "mojibake". Molti ricordano le "è" al posto delle "è" nelle e-mail. E mescolare italiano, russo e arabo nello stesso documento era impossibile.
Unicode: un numero per ogni carattere
Unicode, la cui prima versione è del 1991, risolve il problema alla radice: ogni carattere di ogni scrittura riceve un numero unico, il suo punto di codice, qualunque sia il paese o il programma.
- U+0041: A
- U+00E8: è
- U+0627: ا (alif arabo)
- U+042F: Я (ja cirillica)
- U+1F600: 😀
Unicode conta oggi più di 150.000 caratteri: tutte le scritture moderne, molte antiche, i simboli matematici e le emoji. I suoi primi 128 punti di codice sono esattamente quelli di ASCII.
UTF-8: come vengono memorizzati
Unicode assegna dei numeri; resta da salvarli in byte. La codifica più diffusa è UTF-8, progettata nel 1992 da Ken Thompson e Rob Pike:
- i caratteri ASCII occupano 1 byte, esattamente come prima, quindi un file ASCII è anche un file UTF-8 valido;
- le lettere accentate, l'arabo, il greco, il cirillico e l'ebraico ne occupano 2;
- la maggior parte dei caratteri cinesi, giapponesi e coreani ne occupa 3;
- le emoji ne occupano 4.
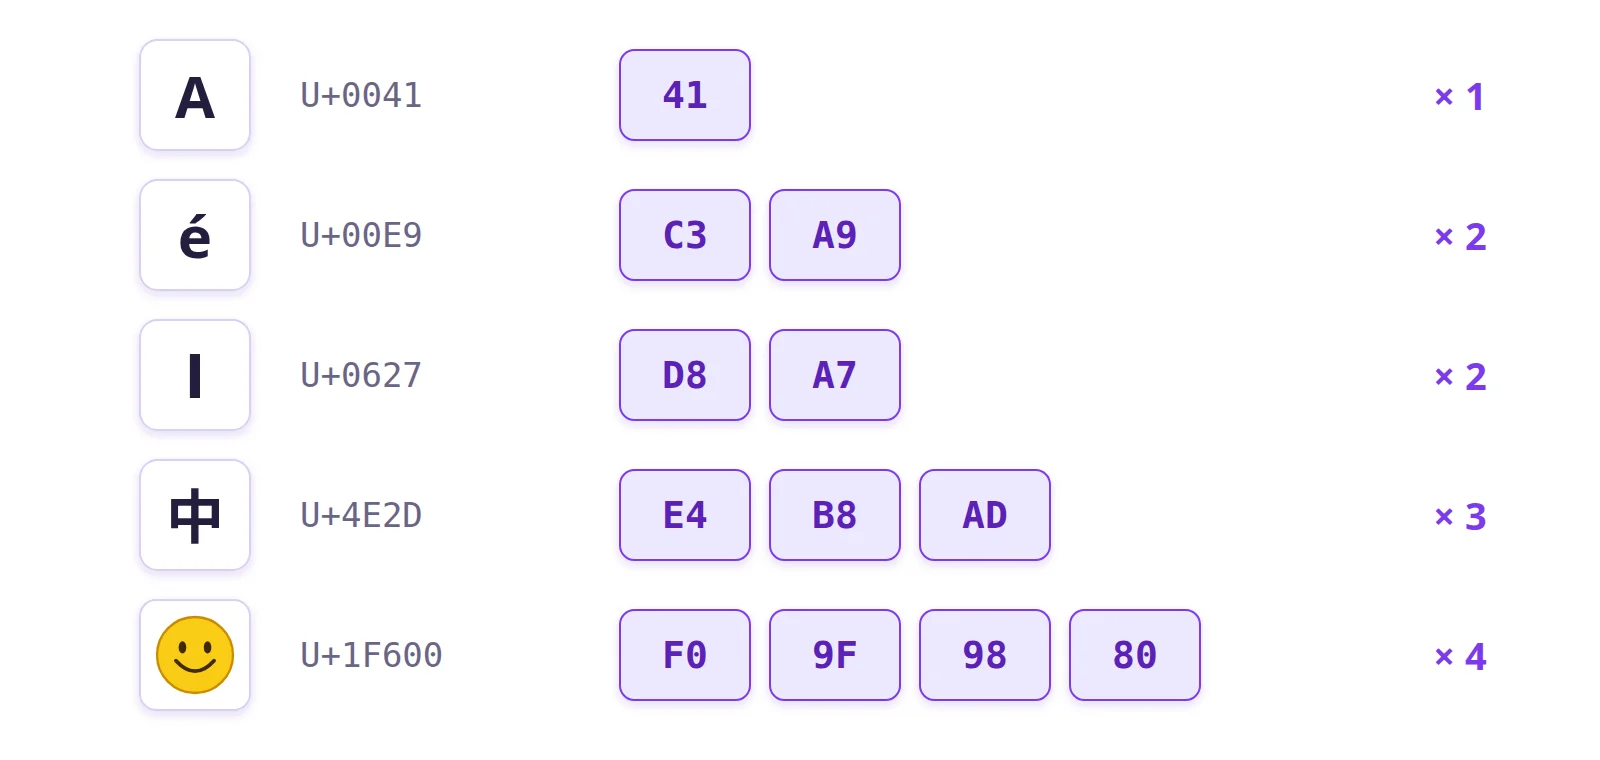
Questa compatibilità con ASCII spiega il suo successo: oggi oltre il 98% dei siti web usa UTF-8. Se un testo mostra ancora "è", quasi sempre è perché un programma ha letto come Windows-1252 qualcosa che era in UTF-8.
Dove si incontra ancora ASCII
- Nel codice: parole chiave, nomi di variabili e operatori sono quasi sempre ASCII.
- Nei protocolli del web e della posta (HTTP, SMTP), che si scambiano i comandi come testo ASCII.
- Nel terminale, dove i colori sono ancora comandati da sequenze che iniziano con il carattere Esc.
- Nelle emoticon come :-) e nell'ASCII art, nate quando si avevano a disposizione solo quei 95 caratteri stampabili.
Per approfondire
- Accenti e lettere speciali: come digitarli
- La storia delle emoji
- Scrivere in cinese: pinyin e wubi
- Tabella ASCII completa
- Il consorzio Unicode
- La storia di UTF-8 raccontata da Rob Pike (in inglese)