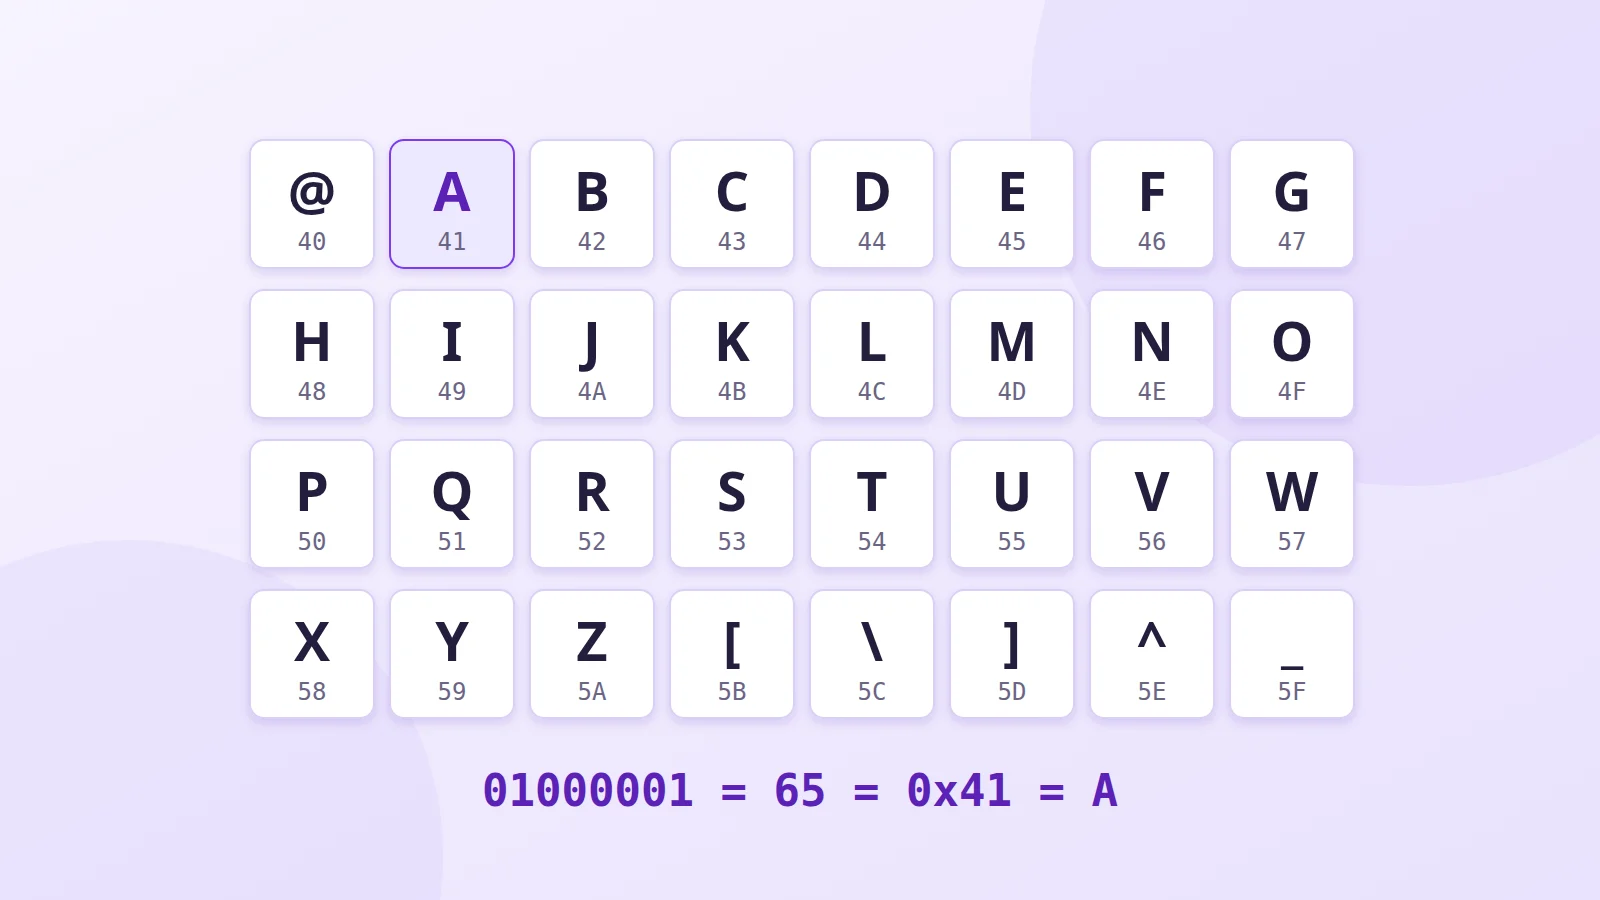
Um computador só entende números. Para mostrar a letra A, ele precisa de uma tabela que diga: "o número 65 é o A". Essa tabela é uma codificação de caracteres. A mais antiga ainda usada em toda parte se chama ASCII; a sucessora, o Unicode, é o que hoje permite ler árabe, russo e emojis na mesma página.
Antes do ASCII: o telégrafo
O código Morse do século XIX já representava as letras com sinais, mas era pensado para o ouvido de um operador, não para uma máquina: cada letra tinha uma duração diferente.
Os teletipos do início do século XX adotaram um código de 5 bits, derivado do inventado pelo francês Émile Baudot e padronizado como ITA2. Cinco bits só dão 32 combinações, poucas para letras e números. Por isso um caractere especial alternava entre o modo "letras" e o modo "números", e um único erro de transmissão podia transformar uma mensagem inteira em algarismos.
O nascimento do ASCII (1963-1967)
No início dos anos 1960, cada fabricante de computadores tinha sua própria codificação, e as máquinas não conseguiam trocar texto. A American Standards Association reuniu então um comitê, com IBM e AT&T entre outros, para definir um código comum: o American Standard Code for Information Interchange, ou ASCII.
O comitê escolheu 7 bits, ou seja, 128 caracteres. A primeira versão, de 1963, nem tinha letras minúsculas; elas chegaram com a revisão de 1967, que depois se espalhou por toda parte.
O que tem na tabela ASCII
- De 0 a 31 e 127: os caracteres de controle. Não aparecem na tela; serviam para comandar os teletipos. Vários continuam em uso: a tabulação (9), a quebra de linha (10), o retorno de carro (13), o Esc (27).
- 32: o espaço.
- De 48 a 57: os algarismos de 0 a 9.
- De 65 a 90: as maiúsculas de A a Z, e de 97 a 122: as minúsculas.
- O resto: pontuação e símbolos como @, #, $ ou {.
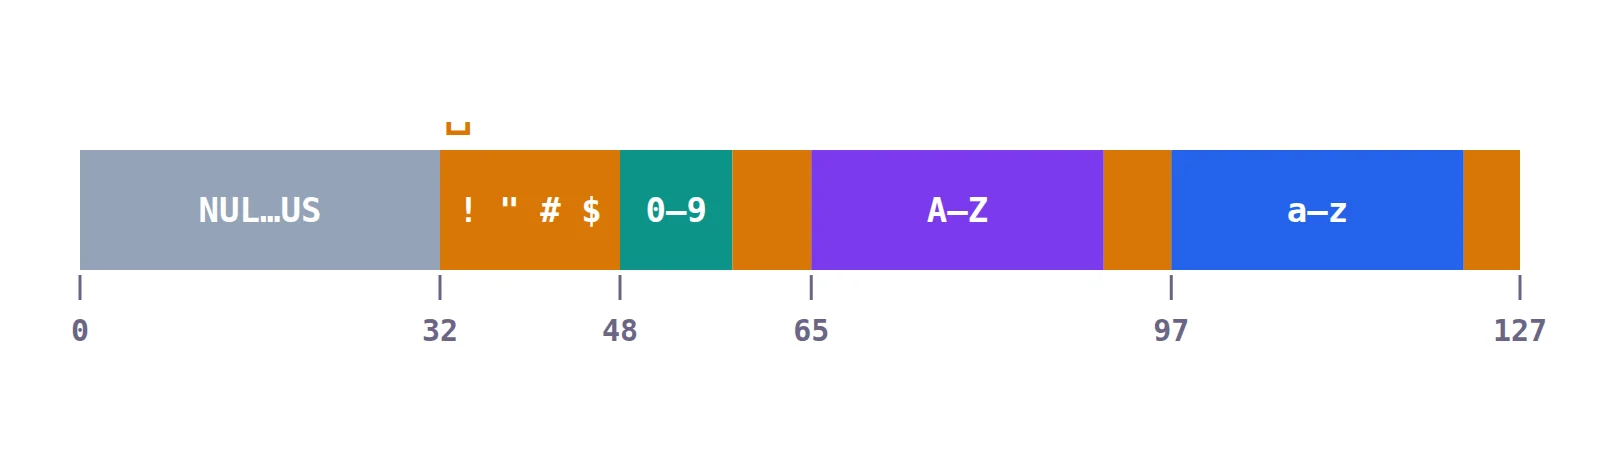
A ordem não é por acaso. As letras seguem a ordem alfabética, o que facilita a ordenação, e uma maiúscula e sua minúscula estão sempre a 32 de distância, o que torna trivial converter uma na outra num programa.
O problema dos acentos
128 caracteres bastam para o inglês, mas não para o resto do mundo. O ASCII não tem ç, ã, é nem nenhuma letra árabe, russa ou chinesa.
Como um byte tem 8 bits, o bit que sobrava foi usado para acrescentar mais 128 caracteres. Mas cada região os preencheu do seu jeito: são as "páginas de código". ISO-8859-1 e Windows-1252 para a Europa Ocidental (e o Brasil), ISO-8859-5 para o cirílico, Windows-1256 para o árabe, Shift-JIS para o japonês…
O mesmo byte podia significar ç no Brasil e uma letra cirílica na Rússia. Lido com a página de código errada, o texto ficava ilegível: é o "mojibake". Muita gente se lembra do "ção" no lugar de "ção" nos e-mails. E era impossível misturar português, russo e árabe no mesmo documento.
Unicode: um número para cada caractere
O Unicode, cuja primeira versão saiu em 1991, resolve o problema pela raiz: cada caractere de cada escrita recebe um número único, o seu ponto de código, seja qual for o país ou o programa.
- U+0041: A
- U+00E7: ç
- U+0627: ا (alif árabe)
- U+042F: Я (ya cirílico)
- U+1F600: 😀
O Unicode tem hoje mais de 150 mil caracteres: todas as escritas modernas, muitas antigas, símbolos matemáticos e emojis. Seus 128 primeiros pontos de código são exatamente os do ASCII.
UTF-8: como eles são guardados
O Unicode atribui números; falta gravá-los em bytes. A codificação mais difundida é o UTF-8, criado em 1992 por Ken Thompson e Rob Pike:
- os caracteres ASCII ocupam 1 byte, exatamente como antes, então um arquivo ASCII também é um arquivo UTF-8 válido;
- as letras acentuadas, o árabe, o grego, o cirílico e o hebraico ocupam 2;
- a maioria dos caracteres chineses, japoneses e coreanos ocupa 3;
- os emojis ocupam 4.
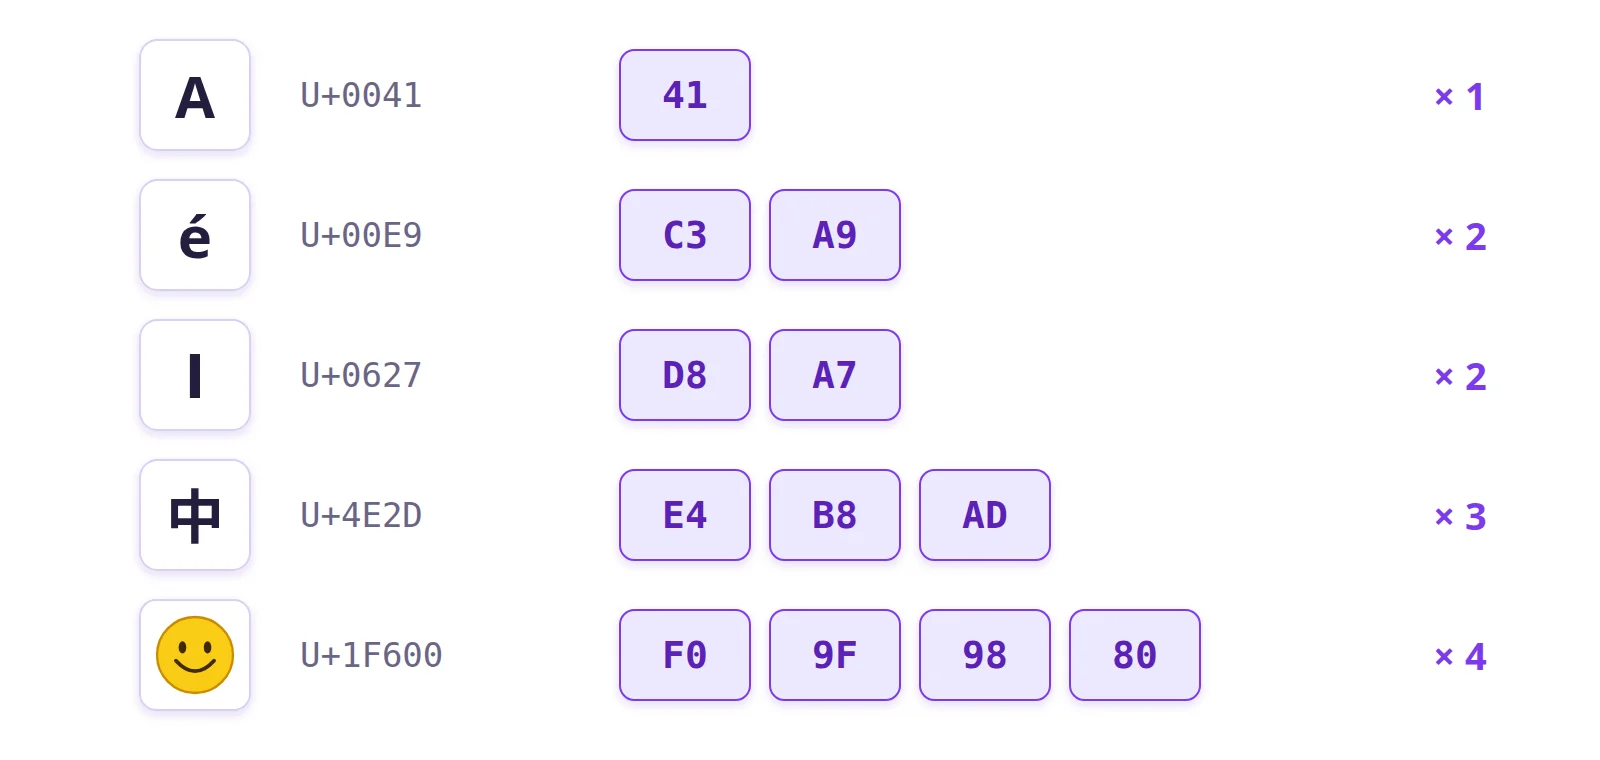
Essa compatibilidade com o ASCII explica o sucesso: hoje mais de 98% dos sites usam UTF-8. Se um texto ainda aparece com "ç", quase sempre é porque um programa leu como Windows-1252 algo que estava em UTF-8.
Onde o ASCII ainda aparece
- No código-fonte: palavras-chave, nomes de variáveis e operadores são quase sempre ASCII.
- Nos protocolos da web e do e-mail (HTTP, SMTP), que trocam seus comandos em texto ASCII.
- No terminal, onde as cores ainda são controladas por sequências que começam com o caractere Esc.
- Nos emoticons como :-) e na arte ASCII, nascidos quando só havia esses 95 caracteres imprimíveis.
Para saber mais
- Acentos e letras especiais: como digitá-los
- A história dos emojis
- Digitar em chinês: pinyin e wubi
- Tabela ASCII completa
- O consórcio Unicode
- A história do UTF-8 contada por Rob Pike (em inglês)