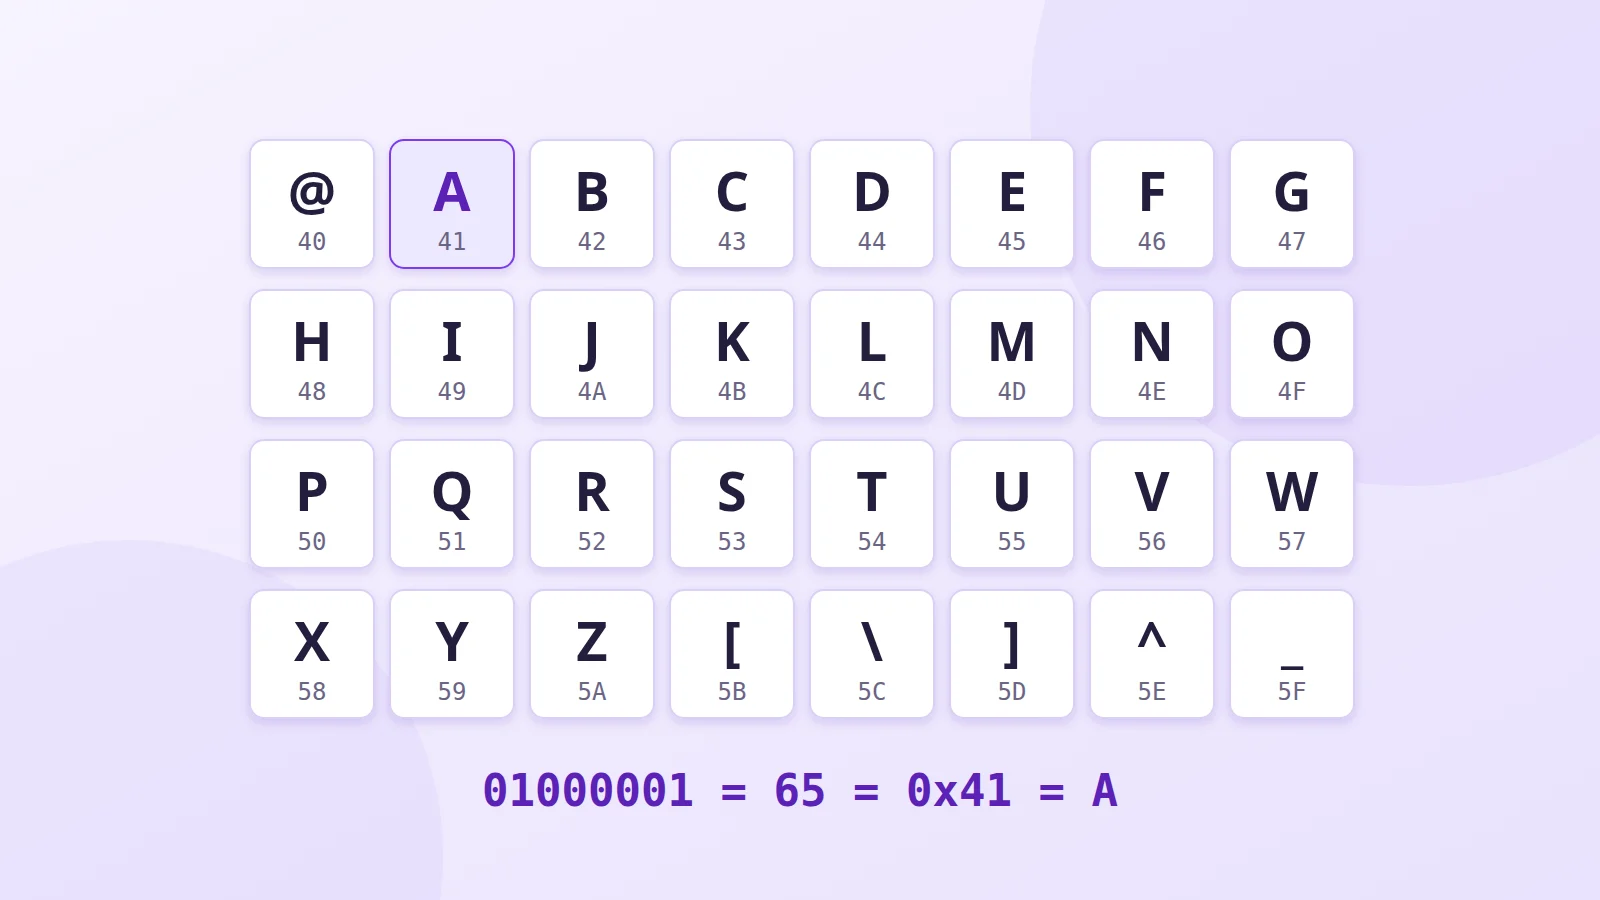
Un ordenador solo entiende números. Para mostrar la letra A necesita una tabla que diga "el número 65 es la A". Esa tabla es una codificación de caracteres. La más antigua que sigue en uso en todas partes se llama ASCII; su sucesora, Unicode, es la que hoy te permite leer árabe, ruso y emojis en la misma página.
Antes de ASCII: el telégrafo
El código Morse del siglo XIX ya representaba las letras con señales, pero estaba pensado para el oído de un operador, no para una máquina: cada letra tenía una duración distinta.
Los teletipos de principios del siglo XX adoptaron un código de 5 bits, derivado del que inventó el francés Émile Baudot y normalizado como ITA2. Cinco bits solo dan 32 combinaciones, insuficientes para letras y cifras. Así que un carácter especial cambiaba entre el modo "letras" y el modo "cifras", y un solo error de transmisión podía convertir todo un mensaje en números.
El nacimiento de ASCII (1963-1967)
A principios de los años sesenta, cada fabricante de ordenadores tenía su propia codificación, y las máquinas no podían intercambiar texto. La American Standards Association reunió un comité, con IBM y AT&T entre otros, para definir un código común: el American Standard Code for Information Interchange, o ASCII.
El comité eligió 7 bits, es decir, 128 caracteres. La primera versión, de 1963, ni siquiera tenía minúsculas; llegaron con la revisión de 1967, que luego se extendió por todas partes.
Qué contiene la tabla ASCII
- Del 0 al 31 y el 127: los caracteres de control. No se muestran; servían para manejar los teletipos. Varios siguen en uso: el tabulador (9), el salto de línea (10), el retorno de carro (13), Escape (27).
- 32: el espacio.
- Del 48 al 57: las cifras del 0 al 9.
- Del 65 al 90: las mayúsculas de la A a la Z, y del 97 al 122: las minúsculas.
- El resto: signos de puntuación y símbolos como @, #, $ o {.
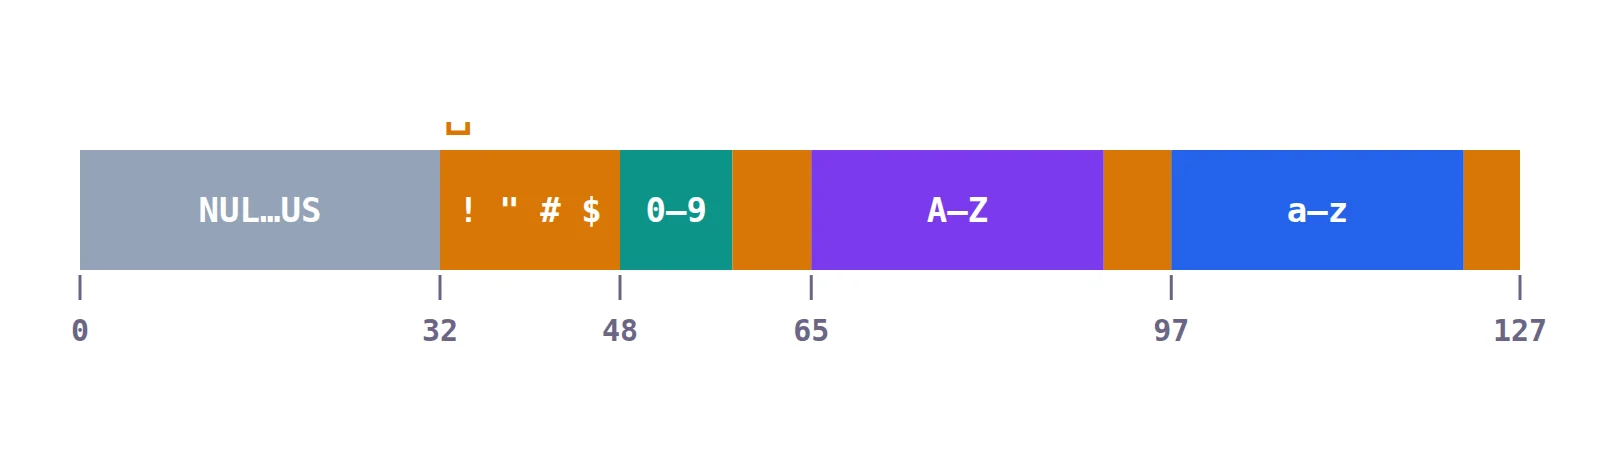
El orden no es casual. Las letras siguen el orden alfabético, lo que facilita ordenar, y una mayúscula y su minúscula siempre están separadas por 32, lo que hace trivial pasar de una a otra en un programa.
El problema de la ñ y los acentos
128 caracteres bastan para el inglés, pero no para el resto del mundo. ASCII no tiene ñ, ni á, ni ü, ni ninguna letra árabe, rusa o china.
Como un byte tiene 8 bits, se usó el bit sobrante para añadir 128 caracteres más. Pero cada región los llenó a su manera: son las "páginas de códigos". ISO-8859-1 y Windows-1252 para Europa occidental, ISO-8859-5 para el cirílico, Windows-1256 para el árabe, Shift-JIS para el japonés…
El mismo byte podía significar ñ en España y una letra cirílica en Rusia. Leído con la página de códigos equivocada, un texto se volvía ilegible: es el "mojibake". Muchos recuerdan las "ñ" que aparecían en lugar de la "ñ" en los correos. Y era imposible mezclar español, ruso y árabe en el mismo documento.
Unicode: un número para cada carácter
Unicode, cuya primera versión se publicó en 1991, resuelve el problema de raíz: cada carácter de cada escritura recibe un número único, su punto de código, sea cual sea el país o el programa.
- U+0041: A
- U+00F1: ñ
- U+0627: ا (alif árabe)
- U+042F: Я (ya cirílica)
- U+1F600: 😀
Unicode tiene hoy más de 150 000 caracteres: todas las escrituras modernas, muchas antiguas, símbolos matemáticos y emojis. Sus 128 primeros puntos de código son exactamente los de ASCII.
UTF-8: cómo se guardan
Unicode asigna números, pero hay que guardarlos en bytes. La codificación más extendida es UTF-8, diseñada en 1992 por Ken Thompson y Rob Pike:
- los caracteres ASCII ocupan 1 byte, igual que antes, así que un archivo ASCII también es un archivo UTF-8 válido;
- la ñ, las vocales acentuadas, el árabe, el griego, el cirílico o el hebreo ocupan 2;
- la mayoría de los caracteres chinos, japoneses y coreanos ocupan 3;
- los emojis ocupan 4.
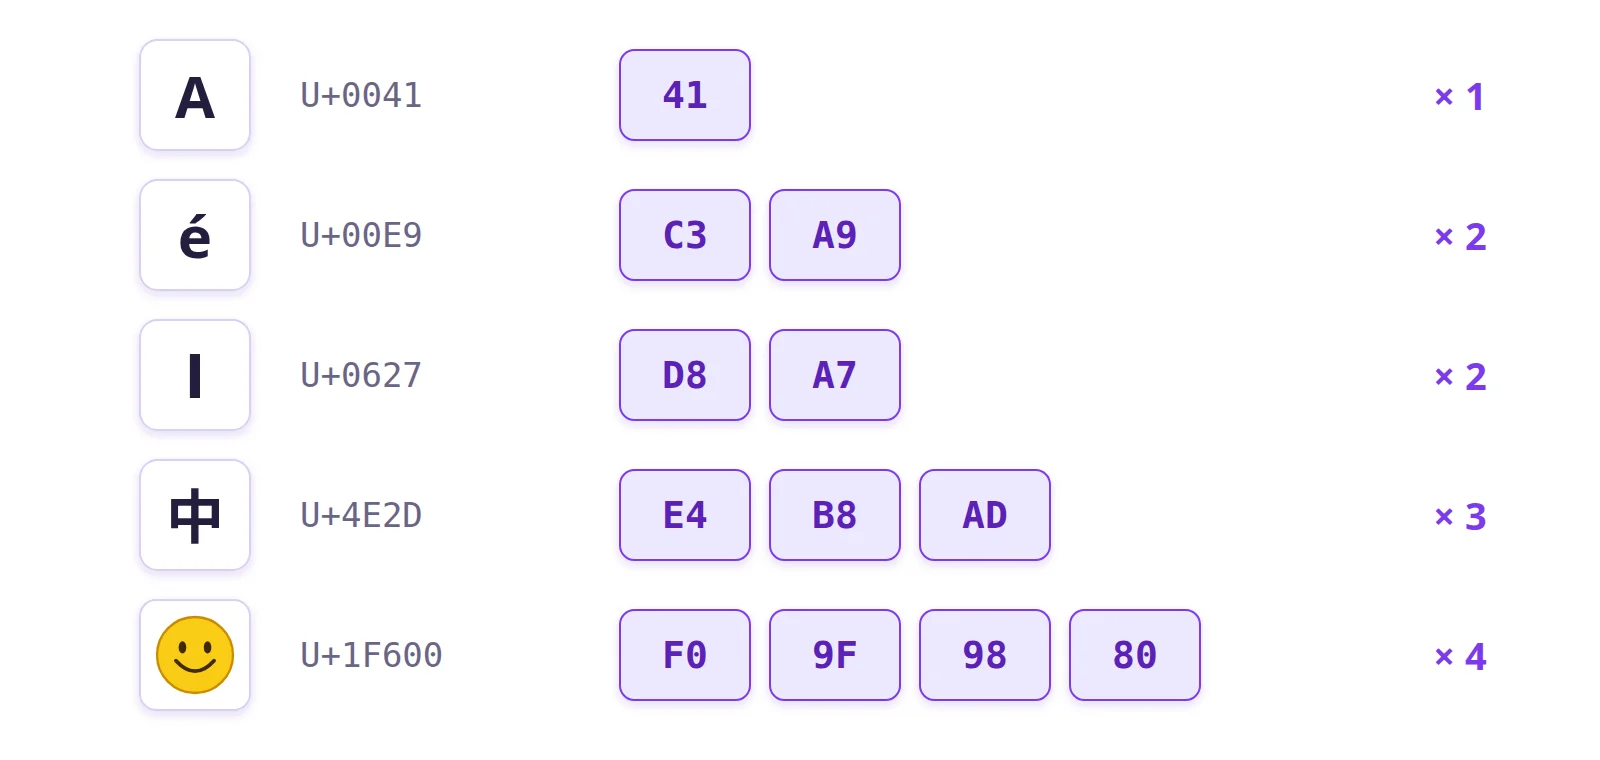
Esa compatibilidad con ASCII explica su éxito: hoy más del 98 % de los sitios web usan UTF-8. Si un texto todavía muestra "ñ", casi siempre es porque un programa leyó como Windows-1252 algo que estaba en UTF-8.
Dónde sigue apareciendo ASCII
- El código fuente: las palabras clave, los nombres de variables y los operadores son casi siempre ASCII.
- Los protocolos de la web y del correo (HTTP, SMTP) intercambian sus órdenes en texto ASCII.
- El terminal, donde los colores se siguen controlando con secuencias que empiezan por el carácter Escape.
- Los emoticonos como :-) y el arte ASCII, nacidos cuando solo se disponía de esos 95 caracteres imprimibles.
Para saber más
- Acentos y letras especiales: cómo escribirlos
- La historia de los emojis
- Escribir en chino: pinyin y wubi
- Tabla ASCII completa
- El consorcio Unicode
- La historia de UTF-8 contada por Rob Pike (en inglés)